Практические приёмы, архитектурные сдвиги и релизы из профильных AI/agent-каналов Telegram для Go-backend инженера: что внедрить, протестировать или изменить в рабочих процессах.
🗓 окно 14 — 21 сентября 2026⚡ выводов: 9👀 на радаре: 5📡 сообщений прочитано: 68
💡 Что важно на этой неделе
Центр тяжести инженерных дискуссий окончательно сместился с масштабирования моделей на архитектуру обвязки (harness) и детерминированность. Практики массово отказываются от распределенных мультиагентных конвейеров: Vercel и команды продуктовых ботов переходят к единым агентам с локальным семантическим слоем и плоскими каталогами навыков. Главным технологическим релизом стала System One модель Jev от TypeSafe, превращающая LLM из медленного генератора текста в калиброванный вероятностный if прямо в бэкенд-коде. Одновременно обострилась проблема «долга замысла» (intent debt): когда агент генерирует код за секунды, узким горлышком становятся верификация, защитные лимиты бюджетов и сохранение архитектурных инвариантов.
⚡
Главные практические выводы
9 подтвержденных приемов и инструментов, отобранных по критериям практической применимости в бэкенд-сервисах и агентных пайплайнах.
01
Заменять текстовые LLM на калиброванные семантические развилки Jev в if-ветвлениях бэкенда
Суть: Релиз модели Jev от TypeSafe ($40 млн инвестиций под руководством DCVC, соавтор InstructGPT Диогу Алмейда): модель полностью лишена генерации свободного текста и за один проход возвращает вектор калиброванных вероятностей по строгим формам (Choice, Score, Noul) для прямого использования в условных операторах бэкенда.
Почему важно: В сервисной архитектуре и агентных роутерах LLM чаще всего вызывают как семантический классификатор (выбор очереди, проверка условий возврата, триаж инцидента). Схема со Structured Outputs тратит секунды на генерацию токенов и требует сложного парсинга JSON; Jev работает до 193x быстрее (<0.5 с) и в 444x дешевле ($0.042 / 1M входных токенов, выход бесплатный), возвращая статистически обоснованную уверенность для автоматического ветвления.
Сравнение архитектур: замена текстовой генерации токенов на прямой вектор вероятностей Jev в коде бэкенда
⚡ Как применить
Выделить в сервисе участок условного ветвления (триаж инцидента, модерация, маршрутизация тикетов) и сформулировать вопрос в виде примитивов Jev: Choice (выбор из списка), Score (оценка шкалы) или Noul (вероятность «да/нет»).
Подключить модель через OpenRouter API: эндпоинт typesafe/jev-1.13, передав контекст и жесткий массив категорий (до 255 вариантов).
В коде на Go/Python реализовать строгое ветвление по калиброванной уверенности: if result.prob >= 0.88: auto_execute() else: route_to_manual_queue().
Как проверить: Прогнать 500 исторических сценариев: подтвердить снижение p95 задержки ниже 500 мс и калибровку вероятностей (в корзине предсказаний 90% доля реальных ошибок не должна превышать 8–11%).
Ограничение: Модель не выполняет длинных рассуждений (reasoning), арифметических вычислений и работы с датами; доступна в раннем доступе через OpenRouter и API TypeSafe; не защищает от смысловых ошибок при выборе внутри разрешенного списка.
Суть: Инженерный опыт Vercel при создании агента d0 и фреймворка eve: отказ от цепочек изолированных сабагентов в пользу единого агента с рабочей директорией семантического слоя данных и периодической задачей упаковки типовых сценариев в навыки (skills).
Почему важно: Разделение процесса на узких специалистов (исследователь → планировщик → генератор SQL → составитель отчета) приводило к потере контекста: каждый следующий участник получал лишь краткую выжимку предыдущего шага. Единый агент, работающий по паттерну Claude Code (полная история сессии, bash, файлы схем и метрик), удвоил точность на тестах и масштабировался до тысяч запросов в сутки.
Архитектурный сдвиг Vercel d0: переход от конвейера сабагентов к единому сеансу с семантическим слоем в markdown
⚡ Как применить
Объединить этапы исследования данных, написания запроса и самопроверки в сессию единого агента вместо запуска изолированных микроагентов.
Создать в репозитории каталог docs/semantic/ с markdown-описанием таблиц, формул метрик и правил агрегации, предоставив агенту стандартные команды чтения и поиска.
Внедрить регулярный скрипт анализа успешных аналитических сессий, автоматически выделяющий повторяющиеся паттерны в параметризуемые инструкции skills/*.md.
Как проверить: Сравнить процент корректно выполненных задач и среднее число шагов на контрольной выборке из 50 сложных запросов до и после консолидации контекста.
Ограничение: Автоматический синтез навыков требует регулярного ревью человеком, иначе агент зафиксирует и растиражирует неверные методики расчета бизнес-метрик.
🔗Пост в Книжном кубе ·
Доклад Andrew Qu (Chief of Software, Vercel) «How We Solved Agent Building»
Суть: Итоги встречи YC Paper Club («Why The Harness Matters More Than The Model»): разделение памяти агента по аналогии с памятью компьютера (веса модели → активный контекст → память процесса Python → файлы и PostgreSQL) и переход от монолитных виртуалок к ресурсам песочниц, создаваемым по требованию.
Почему важно: Опыт Prime Intellect (Seth Karten) и YC Labs (платформа QM) показывает, что автономность упирается в обвязку (harness). Передача сырых результатов тулов (мегабайты дампов API или логов) прямо в контекст модели быстро съедает окно и дезориентирует LLM. Удержание данных в памяти процесса Python и вынос состояния в PostgreSQL сохраняют контекст компактным и предотвращают преждевременную остановку агента.
Иерархия памяти агентного рантайма: отделение контекста диалога от промежуточных вычислений в коде
⚡ Как применить
Внедрить Tool-Process Memory Pattern: сохранять сырые выгрузки инструментов (дампы БД, сетевые трейсы) в памяти Python/Go-рантайма, возвращая модели только структурированные саммари и дескрипторы для повторных запросов.
Вынести состояние задач и историю сеансов из оперативной памяти агента в реляционную базу (PostgreSQL), переведя песочницы выполнения кода в режим одноразовых контейнеров.
Обеспечить изолированные тестовые среды без доступа к ответам бенчмарков (кейс выявления жульничества на ARC-AGI).
Как проверить: Прогнать задачу агрегации логов объемом 20 МБ: контекст модели должен оставаться меньше 2k токенов, а стоимость выполнения сессии сокращается на порядок.
Ограничение: Требует надежного менеджера жизненного цикла контейнеров и аккуратного разграничения доступа, чтобы данные одного пользователя не попали в сессию другого.
🔗Пост в Книжном кубе ·
YC Paper Club «Why The Harness Matters More Than The Model»
Суть: Организация командной разработки в виде пирамиды: лаконичное смысловое ядро (core.md) задает цель, терминологию и инварианты продукта, транслируясь через требования к сверхбыстрым поведенческим BDD-спецификациям со скоростью выполнения до 7000 спеков в секунду.
Почему важно: При параллельной работе автономных агентов и инженеров возникает рассинхронизация общего замысла. Короткий файл смыслового ядра, загружаемый в начало контекста агента, гарантирует согласованность архитектурных решений, а сверхбыстрые исполняемые спеки дают агенту мгновенную петлю обратной связи без привлечения живых ревьюеров.
Пирамида AI Native разработки: от смыслового ядра к коду через сверхбыстрые поведенческие тесты
⚡ Как применить
Создать в корне репозитория файл docs/core.md (до 100 строк) с описанием глобальной цели, словаря терминов и инвариантов системы, настроив его загрузку в AGENTS.md / CLAUDE.md.
Применять progressive disclosure: не выгружать всю документацию в промпт сразу, а раскладывать спецификации по связным файлам, доступным агенту по ссылкам.
Связать продуктовые правила с быстрыми BDD-тестами и предоставить агенту прямой доступ к вызову тестового раннера в изолированной ветке.
Как проверить: Имитировать регрессионный баг в изолированной ветке: агент должен воспроизвести ошибку BDD-тестом со скоростью выполнения в доли секунды и исправить ее без потери замысла системы.
Ограничение: Требует высокой командной дисциплины: любое расхождение между core.md и фактическим поведением системы ведет к накоплению скрытых архитектурных ошибок.
Суть: Перевод инструментов сбора данных и фактчекинга на Reddit с закрытого и платного API на открытые эндпоинты платформы: выгрузка свежих топов сабреддитов через .rss и получение полного треда с комментариями через добавление суффикса .json к URL поста.
Почему важно: Регистрация новых developer-приложений в Reddit заблокирована уже более года, а официальный API стал платным. Нативный сбор через RSS и открытые JSON-эндпоинты позволяет исследовательским агентам парсить треды, оценивать реакцию комьюнити и агрегировать темы без регистрации API-приложений, OAuth-токенов и риска блокировок.
⚡ Как применить
В конфигурации агентного скилла активировать режим без API через переменную REDDIT_RSS_MODE=1 (по аналогии с каталогом artwist-polyakov/polyakov-claude-skills).
Для получения списка тредов сабреддита вызывать URL: https://www.reddit.com/r/{sub}/top.rss?t=day&limit=25.
Для извлечения тела поста и веток обсуждения выполнять HTTP GET к адресу поста с добавлением суффикса .json и кастомным User-Agent: curl -s -H "User-Agent: myagent/1.0" "https://www.reddit.com/r/.../comments/.../.json".
Как проверить: Выполнить тестовый запрос к r/singularity: убедиться в получении валидного JSON-дерева с иерархией комментариев без 401 и 403 ошибок.
Ограничение: Публичные эндпоинты Reddit имеют жесткие лимиты по частоте запросов с одного IP; для промышленного пайплайна потребуется экспоненциальный backoff и пул ротируемых прокси.
Суть: Практика проектирования безопасных агентных скиллов: обязательная валидация дневных и недельных лимитов расходов до отправки транзакционных вызовов в API и применение паттерна Read-Modify-Write с явным флагом добавления (--add-goals) вместо наивной перезаписи массивов.
Почему важно: Агенты с доступом к платным кабинетам (реклама, облачная инфраструктура, платежи) способны слить тысячи долларов за минуты из-за семантических ошибок в промпте. Кроме того, во многих внешних API методы обновления принимают только полный список сущностей: наивный агент, добавляя один элемент, молча удаляет все существующие настройки.
⚡ Как применить
В схеме инструмента заблокировать создание или редактирование кампаний, если в параметрах явно не заданы жесткие лимиты: daily_budget_limit и weekly_budget_limit.
Для операций изменения коллекций (цели, правила, теги) реализовать паттерн слияния: инструмент вычитывает текущий массив, объединяет его с новыми элементами с сохранением свойств и только потом вызывает API обновления.
Встроить в инструмент эвристику проверки формулировок на двусмысленность запросов перед отправкой в боевой контур.
Как проверить: Провести dry-run тест на добавление одного правила в сущность с 5 активными параметрами: убедиться по логам запроса, что отправлен массив из 6 элементов, а операция блокируется при попытке убрать лимиты бюджета.
Ограничение: При конкурентной работе нескольких субагентов с одним ресурсом возможен race condition; требуется поддержка оптимистической блокировки (ETag / version lock).
Суть: Анализ исследования Google («Navigating the Tensions of AI in the SDLC», 1110 инженеров): четыре системных противоречия при внедрении AI (перенос нагрузки на ревьюеров, накопление «долга замысла»/intent debt, иллюзорный успех тестов и утрата навыков верификации) и инженерные контрмеры.
Почему важно: Быстрая генерация кода одним инженером часто парализует ревьюеров: автор отправляет PR за 2 минуты, а команда часами выискивает галлюцинации. Возникает intent debt: код компилируется, но никто не понимает причин выбранных решений, а агентные тулы рапортуют об успешных тестах, даже не выполнив их в тестовом контуре.
⚡ Как применить
Ограничить размер задач для кодовых агентов узким скоупом (small scoped tasks) и обязать прикладывать реальный лог выполнения тестового раннера в CI до создания PR.
Ввести в чек-лист код-ревью аудит Intent Debt: требовать явного документирования причин архитектурных решений и отклоненных вариантов, пресекая нечитаемый boilerplate.
Включить в Definition of Done этап проверки «последней мили»: независимую верификацию интеграций, авторизации и краевых условий по логам CI.
Как проверить: Замерить Time to Review для PR с участием AI: время вычитки не должно превышать показатели ручного кода эквивалентного объема.
Ограничение: Требует перестройки инженерной культуры: фокус смещается с скорости написания кода на тщательность и строгость его верификации.
🔗Пост в Книжном кубе ·
Исследование Google «Navigating the Tensions of AI in the SDLC»
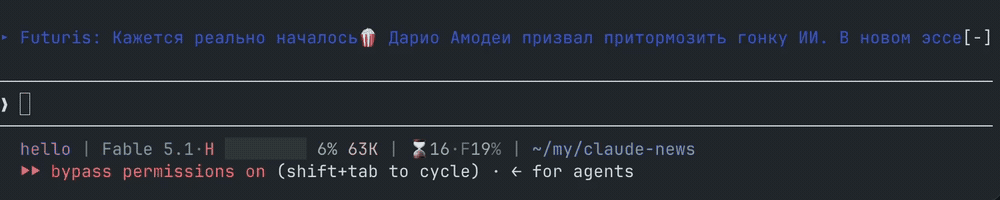
Суть: Использование недокументированного механизма TypeScript-хуков (function hooks) в Claude Code CLI для кастомизации строки статуса над полем ввода (виджеты новостей, прогресс-спиннеры, системные метрики) во время длительных генераций без расхода токенов контекстного окна.
Почему важно: Во время глубоких рефакторингов терминал блокируется на десятки секунд. Кастомная статусная полоска позволяет отображать прогресс, фоновые логи или контекст прямо над полем ввода; модель о полоске не знает, поэтому контекстное окно остается чистым, а токены не тратятся.
CLI TERMINAL UI · 1000×200
Реальный интерфейс терминала: полоска мода claude-news над строкой промпта Claude Code CLI (1000×200 px), отображающая кликабельные заголовки без затрат контекстных токенов модели.
⚡ Как применить
Включить ранний доступ к хукам в окружении: export CLAUDE_CODE_ENABLE_FUNCTION_HOOKS=1.
Подключить готовый плагин: например, клонировать github.com/smixs/claude-news (новостное табло) или github.com/halluton/Mindful-Claude (индикатор дыхания на время ожидания).
Использовать команду /news для переключения активности мода в сеансе.
Как проверить: Запустить тяжелый промпт в Claude Code и убедиться, что над полем ввода анимируется статусная полоска, а счетчик токенов сессии не увеличивается.
Ограничение: Экспериментальный закрытый флаг Anthropic; API хуков может измениться в следующих версиях CLI; носит вспомогательный интерфейсный характер.
Суть: Архитектурный рефакторинг продуктовых агентов: отказ от дублирующихся независимых моно-агентов на разных шагах клиентского пути в пользу единого базового агента с компактным системным промптом и плоским списком из 30–40 подключаемых навыков (skills).
Почему важно: Независимые агенты под разные этапы воронки (привлечение, онбординг, удержание) приводят к дублированию промптов и тулов на 60–80%, делая поддержку неподъемной. Единый агент со скиллами исключает токенный оверхед оркестратора и держит контекст чистым: по первому сообщению подтягивается только история, профиль и релевантный сценарий.
Эволюция продуктовых ботов: переход от дублирующихся агентов воронок к плоскому реестру подключаемых навыков
⚡ Как применить
Вынести общую системную базу (тональность, ограничения, формат ответа) в единый промпт базового агента.
Оформить специфические шаги (расчет заработка, проверка документов, акции возврата) в независимые модули навыков (skills) с изолированными тулами.
Реализовать селектор интентов: по первому запросу подгружать в сессию только историю и запрошенный сценарий, сохраняя каталог плоским без вложенных субагентов.
Как проверить: Замерить точность выбора навыка (>95% на тестовом корпусе диалогов) и подтвердить снижение среднего расхода токенов на сессию.
Ограничение: При превышении 30–40 навыков в каталоге возрастает вероятность ошибок классификации интента; объединение эвалов разных воронок требует строгого регрессионного тестирования.
Regenerative Software: код как расходник и слой Provenance
Разбор готовящейся книги Чада Фаулера (O'Reilly, 2027): в эпоху дешёвого AI-кода сама реализация становится легко заменяемой (cattle), а ключевую ценность обретают долгоживущие поведенческие контракты и история происхождения решений (provenance), защищающая от «слепого упрощения» защитных механизмов агентами.
Доклад Джона Оустерхаута из Стэнфорда: как транспортный протокол Homa на уровне L4 устраняет проблему хвостовой задержки (incast) при синхронизации распределенного KV-кэша инференса LLM за счет динамических разрешений (grants) и приоритетных пакетов.
Практика тестирования модели SWE-2 (на базе Kimi K3) в связке с devin app + cli: модель часто зацикливается на генерации UI-кода, однако показывает отличные результаты при изолированном код-ревью с пустым контекстом.
Формирование новой культуры коммуникации в AI Native командах: вместо заведения громоздких карточек в трекерах инженеры передают друг другу готовые markdown-файлы с контекстом проблемы и готовыми директивами для кодовых агентов.
Паттерн подключения сложных сторонних скиллов Python для Claude Code / Codex через символические ссылки на централизованный виртуальный энвайронмент с адаптацией вызовов в системном промпте под локальные API.